让数据为 AI 而生
重新定义数据的组织方式、调用方式与安全方式,让企业数据天然适配大模型消费场景。
让企业数据真正成为 AI 时代的核心生产资料
数据基座是企业级 AGI 平台的两大核心底座之一,与模型底座并列。它连接企业海量数据资产与上层 AI 能力,提供从数据接入、治理、知识沉淀到安全供给的一体化能力,让企业数据以可控、可信、可调用的方式服务于大模型与智能业务应用。
数据基座不是再建一个数据平台,而是把企业数据资产整理成 AI 可以稳定消费的生产资料,并让所有上层产品和 Agent 统一复用。
重新定义数据的组织方式、调用方式与安全方式,让企业数据天然适配大模型消费场景。
支持全栈私有化部署,企业数据全程驻留在自有环境中,保障数据主权与合规底线。
将指标体系、业务规则、行业经验与专家知识沉淀为可被 AI 复用的结构化资产。
统一对接、统一治理、统一供给,避免重复建设,加速企业 AI 应用从 0 到 1、从 1 到 N 的规模化落地。
让每一条高价值数据,都能稳定进入模型与业务决策。
面向模型的日均数据通量,支撑 EB / PB 级数据洪流稳定流转。
统一数据服务接口低延迟、高并发,单接口可达 10 万+ QPS 供给能力。
流批一体处理千亿级事件量,复杂场景下实现秒级查询与实时出数。
高压缩比编码把常见场景存储压缩至原始体量的三到五分之一,让数据用得起。
统一企业多源数据、治理体系、知识资产与权限边界,为上层 AI 应用提供可控、可信、可调用的数据上下文。
数据库、数据仓库、数据湖、API、文件与流式数据统一接入。
自动识别表结构、字段语义与关联关系,统一管理资产目录、血缘与生命周期。
将指标口径、行业规则、业务逻辑与专家经验结构化为 AI 可复用资产。
行列级权限、上下文按需加载、审计追踪与私有部署共同守住企业边界。
传统数据平台面向人,数据基座面向模型。它让模型理解业务术语、遵循权限边界、调用可信数据,并把企业知识持续沉淀为可复用的数据智能资产。
数据基座将 Schema、元数据、指标体系、语义层、权限规则与缓存加速组合成一条面向 AI 的数据服务链路,让上层应用获得稳定、准确、可审计的数据上下文。
支持关系型数据库、数据仓库、数据湖、API、文件与流式数据,低代码连接器帮助企业快速完成接入。
自动加载 Schema、管理元数据和血缘,沉淀指标体系、语义层、行业规则与专家经验。
通过行列级权限、上下文按需加载与审计追踪,让模型只能看到被授权且符合业务口径的数据。
通用大模型人人可用,但懂你业务、用你数据、守你边界的 AI 能力,必须建立在企业自己的数据基座之上。数据基座把数据资产转化为可持续进化的业务智能引擎。
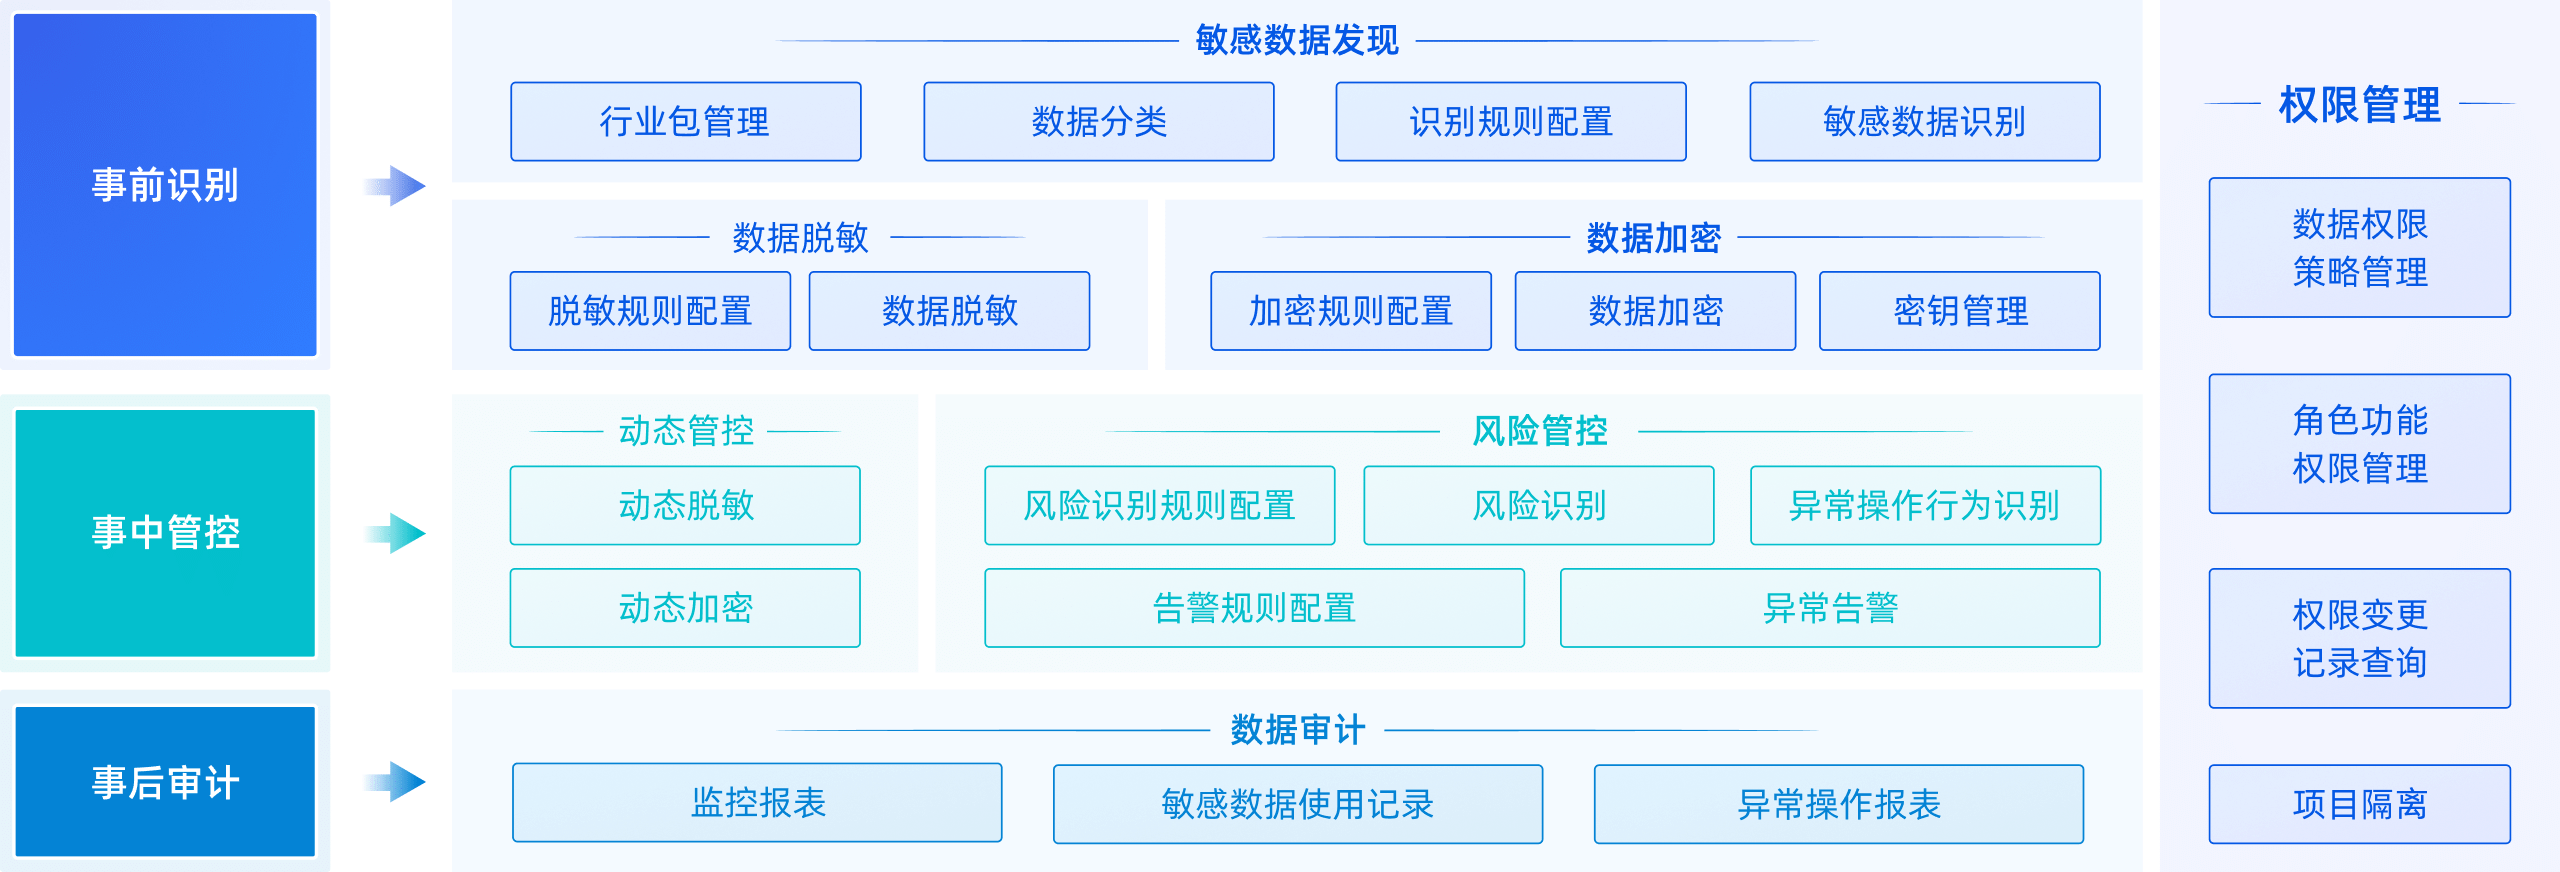
DataBlack,奇点云自主研发的数据安全引擎,遵循以数据为中心的安全架构设计理念,支撑企业完成数据全生命周期安全管控,强化企业数据安全治理能力与风险防御能力,为数据资产安全保驾护航。
更全面,更智能
围绕数据流动路径,聚焦敏感数据,实施全面安全管控。
通过智能算法,对数据进行扫描,结合模型训练能力,帮助企业更快更精准地识别敏感资产。
支持全面数据审计,提供敏感数据使用等记录明细,满足企业安全合规审计的需求。
通过数据的静态与动态脱敏、加密与解密应用,灵活满足敏感数据在使用、存储以及共享场景下的隐私保护需求。
通过自定义规则或智能算法,监控平台用户的风险操作行为,并依据安全策略提供审计明细进行追溯。
覆盖数据全生命周期安全
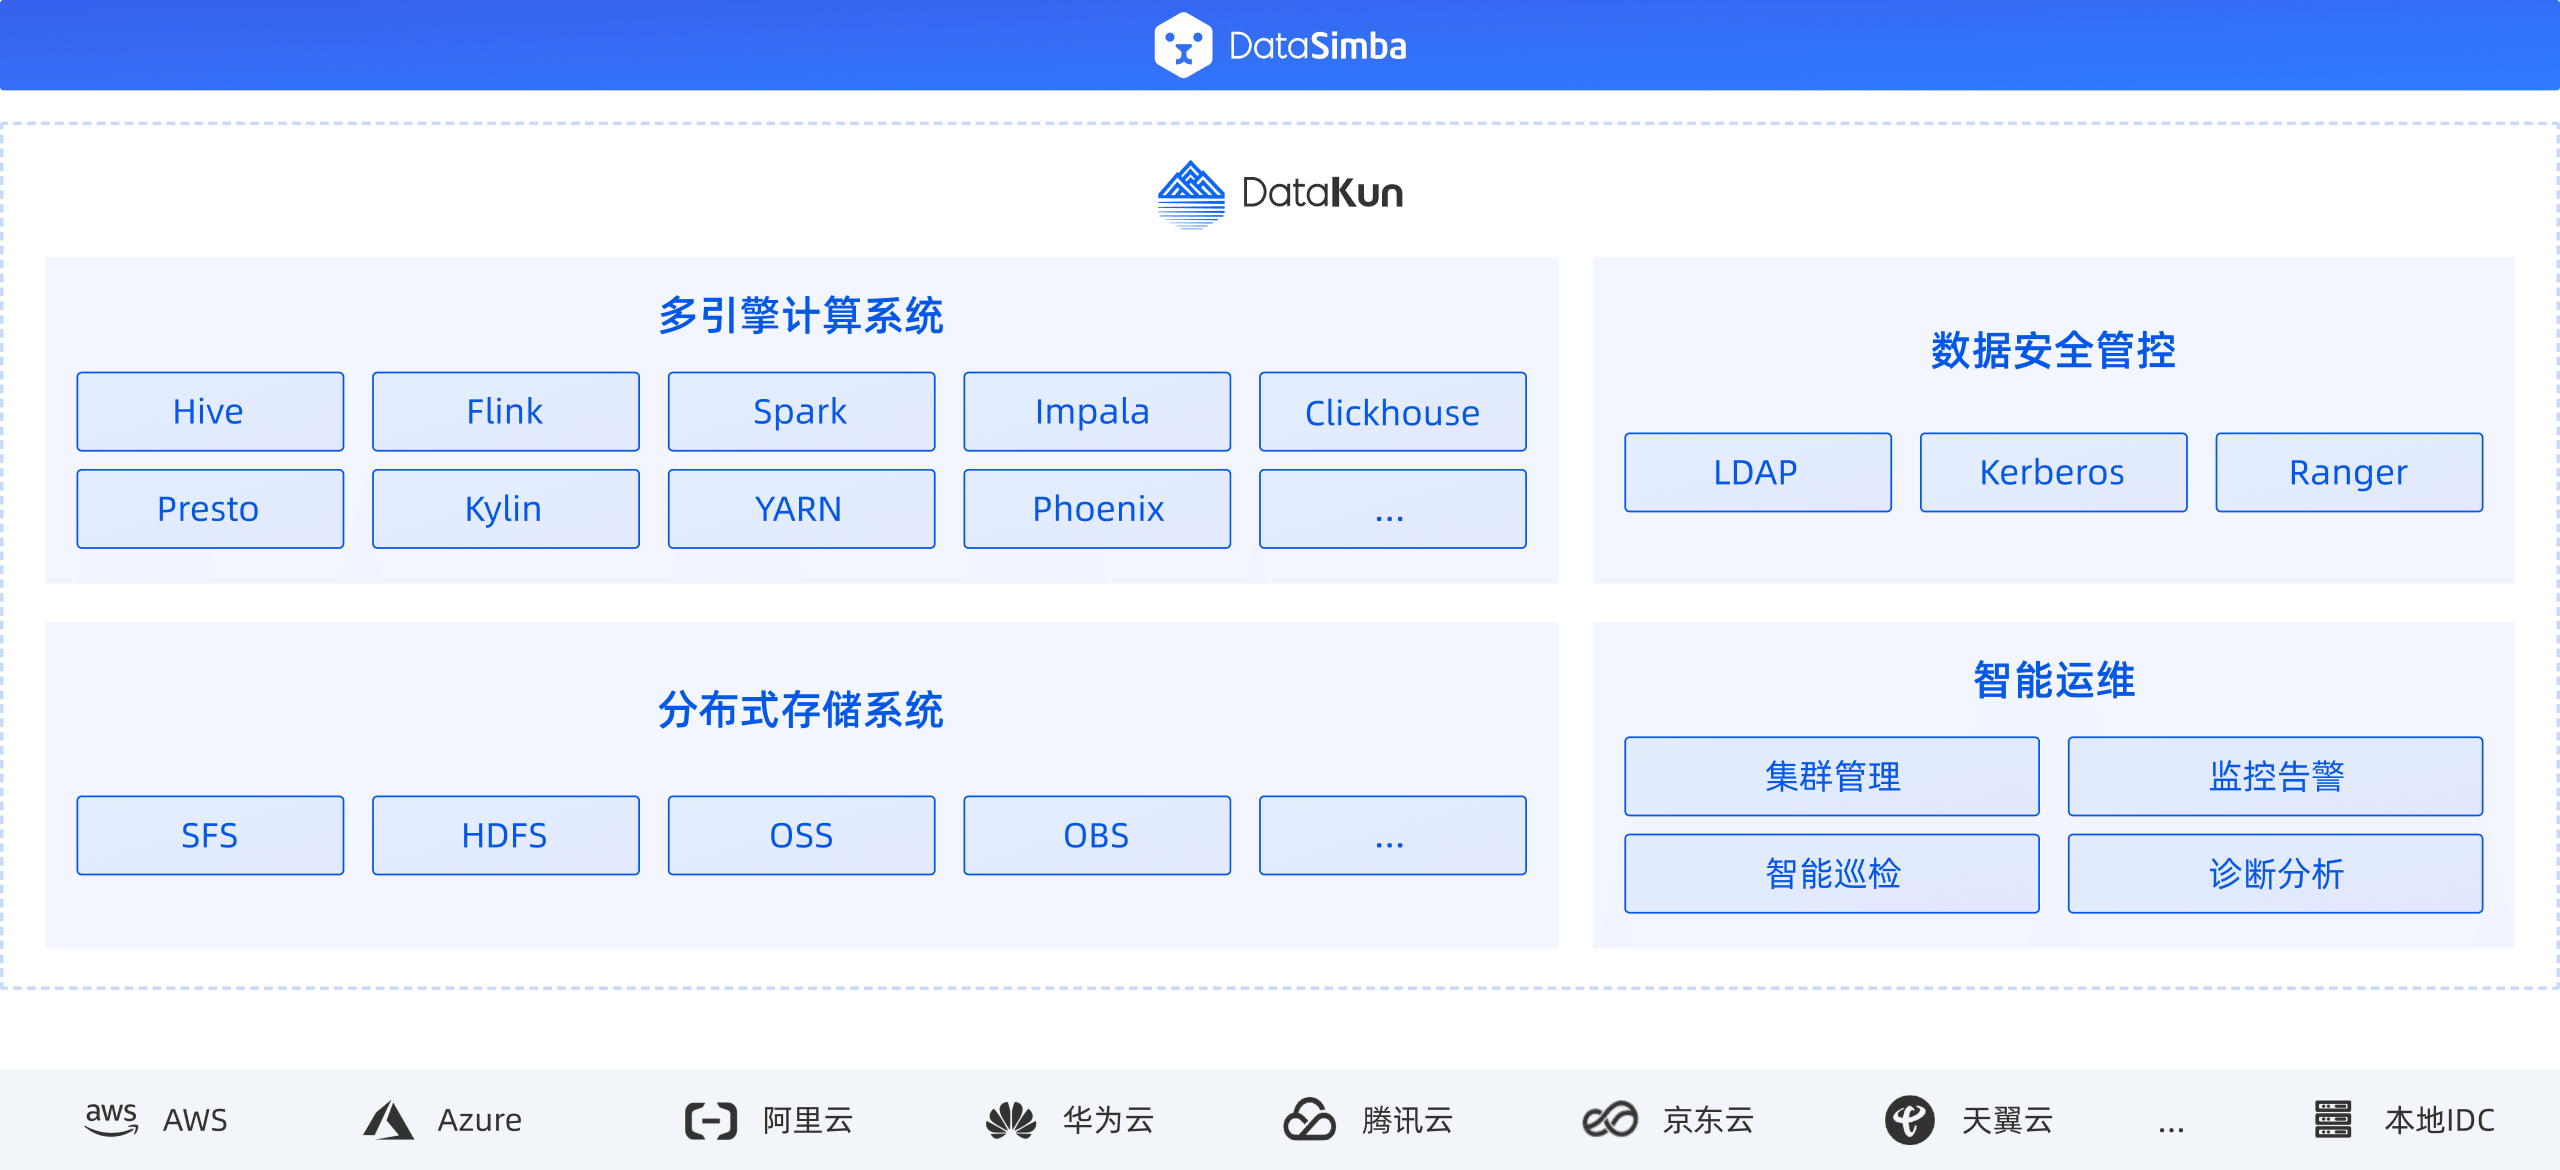
DataKun 是自主可控的数据存算引擎,帮助企业构建智能化、轻量级的大数据基础平台,快速建立其自有的大数据分析处理能力。DataKun 支持各类型大数据 Job 和 Service 的计算与存储,支持自定义组件,提供预置最佳实践版本组合,并保证对关键节点的持续更新,真正实现“客户可控”。
技术可控,成本可控
开放、可掌握、可迭代、可持续供应